JuiceFS 元数据迁移演练手册(测试集群实战版)

目标:在你的测试 K8s 集群里,把"Redis → TiKV 元数据迁移"完整演练一遍:
只读导出 → 临时 TiKV → 导入验证 → 真挂载 → 完整切换回滚。
所有命令已按你的实测环境写好,照敲即可;玩坏了随时推倒重来。

0. 已实测的环境信息(直接可用)

项目实测值来源
文件系统名my-jfsMount Pod 的 mount 输出
Redis 地址juicefs-redis.juicefs-system.svc.cluster.local:6379 db 0Mount Pod cmdline
Redis Podjuicefs-system/juicefs-redis-0(StatefulSet + local-path)kubectl get pod
Mount Pod ×2kube-system/juicefs-liu-node1-pvc-18d437a4-1d22-4b9b-b2a9-2bbeb9d6c7bb-spcuko(node2 上还有一个 -ijvuhmkubectl get pod
业务 PVCdefault/nginx-www-pvc(动态)+ default/juicefs-archive-pvc(静态,当前闲置)kubectl get pv/pvc
Secret ×4kube-system/juicefs-sc-secretkube-system/juicefs-pvc-18d4...-secretkube-system/juicefs-juicefs-archive-pv-secretjuicefs-system/juicefs-redis-secretkubectl get secret
Redis 密码<REDIS密码> ← 占位,执行 §1.2 解码获得
master 内网 IP<MASTER_IP> ← 占位,kubectl get nodes -o wide 查看
# 全文统一用这两个变量,先 export 一次
export MOUNT_POD=juicefs-liu-node1-pvc-18d437a4-1d22-4b9b-b2a9-2bbeb9d6c7bb-spcuko
export MASTER_IP=<MASTER_IP>

1. 阶段 0:现状确认(部分已完成)

# 1.1 挂载确认 ✅ 已完成,输出:JuiceFS:my-jfs on /jfs/pvc-... type fuse.juicefs
kubectl -n kube-system exec $MOUNT_POD -- sh -c "mount | grep -i juicefs"

# 1.2 拿密码(解码主 Secret 的 metaurl,顺手看有没有 secret-key 字段)
kubectl -n kube-system get secret juicefs-sc-secret \
  -o go-template='{{range $k,$v := .data}}{{$k}}: {{$v | base64decode}}{{"\n"}}{{end}}'

# 1.3 版本(≥1.3.0 才能用 --binary,低了就去掉 --binary 改用 .json)
kubectl -n kube-system exec $MOUNT_POD -- juicefs version

# 1.4 活跃会话(对应生产"三道闸"第一道;现在有 1~2 个会话是正常的)
kubectl -n kube-system exec $MOUNT_POD -- \
  juicefs status redis://:<REDIS密码>@juicefs-redis.juicefs-system.svc.cluster.local:6379/0

# 1.5 Redis 里的 key 总量(等下和 dump 条目数对账)
kubectl -n juicefs-system exec juicefs-redis-0 -- redis-cli -a '<REDIS密码>' --no-auth-warning info keyspace
kubectl -n juicefs-system exec juicefs-redis-0 -- redis-cli -a '<REDIS密码>' --no-auth-warning -n 0 dbsize

质量门 G0:版本明确、密码拿到、keyspace 有输出。

2. 阶段 1:只读导出演练(业务不停,零风险)

dump 对 Redis 只有读操作,随便跑。正式迁移的区别只是"停写后再导一次"。
# 2.1 导出(计时!这个耗时就是未来评估真实窗口的依据)
kubectl -n kube-system exec -it $MOUNT_POD -- sh -c "
  time juicefs dump \
    'redis://:<REDIS密码>@juicefs-redis.juicefs-system.svc.cluster.local:6379/0' \
    /tmp/meta-test.zstd --binary --keep-secret-key &&
  ls -lh /tmp/meta-test.zstd"
# 记录:输出里的 entry 数量、耗时、文件大小
# entry 数应≈dbsize 数量级;差太多要贴出来分析

# 2.2 拷到 master 异地备份(养成习惯:导完必拷出)
kubectl cp kube-system/$MOUNT_POD:/tmp/meta-test.zstd ~/meta-test.zstd
md5sum ~/meta-test.zstd

质量门 G1:dump 无报错、文件已拷出、md5 已记录。

3. 阶段 2:临时 TiKV + 导入 + 免挂载验证

3.1 master 上起 tiup playground(前台运行,Ctrl+C 即销毁)

curl --proto '=https' --tlsv1.2 -sSf https://tiup-mirrors.pingcap.com/install.sh | sh
source ~/.bash_profile 2>/dev/null || source ~/.bashrc

tiup playground v8.1.0 --db 0 --kv 1 --pd 1 --tiflash 0 --without-monitor
# 启动后打印 PD 地址(127.0.0.1:2379);另开一个 SSH 终端继续下面操作
playground = 一次性玩具集群,只起 PD+TiKV(JuiceFS 用不上 TiDB/TiFlash)。生产的区别是 tiup cluster 部署 3+3 并常驻,原理相同。

3.2 master 上装 JuiceFS 客户端并导入

从 master 直连 127.0.0.1:2379,网络最简单,排除 Pod→节点网络的变数。
curl -sSL https://d.juicefs.com/install | sh -
juicefs version

time juicefs load tikv://127.0.0.1:2379/jfs ~/meta-test.zstd

3.3 免挂载验证(重点教学:ls/fsck 不经过 FUSE,直接查元数据引擎)

# 新引擎侧
juicefs ls   tikv://127.0.0.1:2379/jfs /
juicefs fsck tikv://127.0.0.1:2379/jfs /

# 旧引擎侧(master 访问不了 svc 域名,用 ClusterIP 或回 Mount Pod 执行)
kubectl -n juicefs-system get svc juicefs-redis    # 拿到 ClusterIP
juicefs ls 'redis://:<REDIS密码>@<ClusterIP>:6379/0' /

# 两边目录树一致 + fsck 通过 = 迁移数据正确

质量门 G2:load 完成无报错、两侧 ls 一致、fsck 通过。

4. 阶段 3(可选):真·FUSE 挂载 TiKV 版

mkdir -p /mnt/jfs-test
juicefs mount tikv://127.0.0.1:2379/jfs /mnt/jfs-test &
sleep 3
mount | grep jfs-test                 # 确认挂上
ls -R /mnt/jfs-test | head -50        # 文件树对比
find /mnt/jfs-test -type f | head -5 | xargs -I{} sh -c 'echo "== {}"; head -c 200 {} ; echo'
# 抽样读内容:能读出 = 元数据→对象存储全链路通
umount /mnt/jfs-test

5. 进阶 A:去掉 --keep-secret-key 重跑(演练 SK 丢失预案)

对应生产最大风险项:dump 默认不导出对象存储 SK,load 后要手动补。
# 5.1 重新导出(去掉 --keep-secret-key)+ 换个 TiKV 前缀
kubectl -n kube-system exec -it $MOUNT_POD -- sh -c "
  juicefs dump 'redis://:<REDIS密码>@juicefs-redis.juicefs-system.svc.cluster.local:6379/0' \
    /tmp/meta-nosk.zstd --binary"
kubectl cp kube-system/$MOUNT_POD:/tmp/meta-nosk.zstd ~/meta-nosk.zstd
juicefs load tikv://127.0.0.1:2379/jfs-nosk ~/meta-nosk.zstd

# 5.2 此时 fsck 会报访问对象存储失败(SK 缺失)→ 演练补密钥
juicefs config tikv://127.0.0.1:2379/jfs-nosk \
  --access-key <AK> --secret-key <SK>        # AK/SK 从 juicefs-sc-secret 解码获得

# 5.3 再次 fsck 验证恢复
juicefs fsck tikv://127.0.0.1:2379/jfs-nosk /

6. 进阶 B:完整 CSI 切换演练(生产最险一步的彩排)

流程:备份 Secret → 试连通 → 改 metaurl → 重建 Mount Pod → 验证 → 回切。
在测试集群随便玩,玩坏回切即可。
# 6.1 备份所有相关 Secret(回滚的命根子)
mkdir -p ~/secret-backup
for s in "kube-system juicefs-sc-secret" \
         "kube-system juicefs-pvc-18d437a4-1d22-4b9b-b2a9-2bbeb9d6c7bb-secret" \
         "kube-system juicefs-juicefs-archive-pv-secret"; do
  set -- $s
  kubectl -n $1 get secret $2 -o yaml > ~/secret-backup/$2.yaml
done
ls -la ~/secret-backup/

# 6.2 前置试连通:Pod 能否访问 master:2379(不通则本进阶做不了,看下方备注)
kubectl -n kube-system exec $MOUNT_POD -- sh -c "nc -zv $MASTER_IP 2379 || echo UNREACHABLE"

# 6.3 停写(演练版):缩容业务 Deployment,确认 Mount Pod 消失
kubectl get deploy -n default                    # 找到用 nginx-www-pvc 的 deploy
kubectl -n default scale deploy <业务DEPLOY名> --replicas=0
sleep 10
kubectl -n kube-system get pod | grep juicefs-liu    # Mount Pod 应消失(CSI 按需创建)

# 6.4 正式导出(停写后的"一致性版本")→ 导入新前缀 /jfs-prod
kubectl -n kube-system run juicefs-migrator --image=juicedata/mount:ce-v1.3.0 \
  --restart=Never --overrides='{"spec":{"hostNetwork":true,"dnsPolicy":"ClusterFirstWithHostNet",
  "containers":[{"name":"juicefs-migrator","image":"juicedata/mount:ce-v1.3.0",
  "command":["sleep","3600"],"securityContext":{"privileged":true}}]}}'
kubectl -n kube-system exec -it juicefs-migrator -- sh -c "
  juicefs dump 'redis://:<REDIS密码>@juicefs-redis.juicefs-system.svc.cluster.local:6379/0' \
    /tmp/meta-prod.zstd --binary --keep-secret-key &&
  juicefs load tikv://$MASTER_IP:2379/jfs-prod /tmp/meta-prod.zstd &&
  juicefs fsck tikv://$MASTER_IP:2379/jfs-prod /"

# 6.5 计算新 metaurl 的 base64 并 patch 三个 CSI Secret
NEW_B64=$(echo -n "tikv://$MASTER_IP:2379/jfs-prod" | base64 -w0)
echo $NEW_B64
for s in juicefs-sc-secret juicefs-pvc-18d437a4-1d22-4b9b-b2a9-2bbeb9d6c7bb-secret juicefs-juicefs-archive-pv-secret; do
  kubectl -n kube-system patch secret $s --type merge -p "{\"data\":{\"metaurl\":\"$NEW_B64\"}}"
done
kubectl -n kube-system get secret juicefs-sc-secret -o jsonpath='{.data.metaurl}' | base64 -d; echo
# 确认显示 tikv://...

# 6.6 拉起业务 → CSI 用新 metaurl 重建 Mount Pod
kubectl -n default scale deploy <业务DEPLOY名> --replicas=2
sleep 15
kubectl -n kube-system get pod | grep juicefs-liu    # 新的 Mount Pod 出现

# 6.7 验证切换生效(cmdline 里应该是 tikv:// 了)
NEWPOD=$(kubectl -n kube-system get pod | grep juicefs-liu-node1 | awk '{print $1}' | head -1)
kubectl -n kube-system exec $NEWPOD -- sh -c "cat /proc/1/cmdline | tr '\0' ' '; echo"
kubectl -n default get pods    # 业务 Running
# 进业务 Pod 读写一个文件验证(按你的业务实际路径)

# 6.8 回切演练(完整走一遍回滚)
kubectl -n default scale deploy <业务DEPLOY名> --replicas=0
for s in juicefs-sc-secret juicefs-pvc-18d437a4-1d22-4b9b-b2a9-2bbeb9d6c7bb-secret juicefs-juicefs-archive-pv-secret; do
  kubectl replace -f ~/secret-backup/$s.yaml --force
done
kubectl -n default scale deploy <业务DEPLOY名> --replicas=2
kubectl -n kube-system exec $(kubectl -n kube-system get pod | grep juicefs-liu-node1 | awk '{print $1}' | head -1) \
  -- sh -c "cat /proc/1/cmdline | tr '\0' ' '; echo"    # 确认回到 redis://

# 6.9 清理迁移 Pod
kubectl -n kube-system delete pod juicefs-migrator
6.2 不通的备选:把 playground 绑到 node 节点上起、或给 playground 所在网卡放通、或跳过进阶 B(生产 TiKV 在同 VPC ECS 上,天然可达)。先搞清楚为什么不通,这个排错过程本身就是学习。

质量门 G3:切换后 cmdline 显示 tikv:// 且业务读写正常;回切后显示 redis:// 且业务正常。

7. 清场

# playground 终端按 Ctrl+C(TiKV 数据随之销毁,无所谓)
umount /mnt/jfs-test 2>/dev/null; rmdir /mnt/jfs-test
kubectl -n kube-system delete pod juicefs-migrator 2>/dev/null
# Secret 备份目录留着,正式迁移时还是模板
# ~/meta-test.zstd ~/meta-nosk.zstd 留作纪念/对比

8. 演练 ↔ 生产对照表

演练里做的生产对应
juicefs status 看会话停写三道闸第一道(Sessions 必须为空)
dump 计时正式窗口时长测算
tiup playground(1 PD + 1 TiKV)tiup cluster 部署 PD×3 + TiKV×3 + 监控
load + ls/fsck 验证正式导入 + 质量门(含 entry 对账)
去掉 --keep-secret-key + config 补 SKSK 丢失应急预案
改 3 个 Secret + 重建 Mount Pod生产 CSI 切换的标准动作
kubectl replace 回切生产回滚预案
master 装客户端挂载宿主机场景的验证方式

9. 自查题(能答才算练会)

  1. 为什么 dump 可以业务不停随便跑,正式切换却必须停写后再导一次?
  2. load 中断为什么可以直接重试?要不要重新 dump?
  3. 为什么 juicefs ls/fsck 不需要挂载就能验证元数据?
  4. --keep-secret-key 加与不加的区别?生产怎么选?
  5. 改完 Secret 为什么要重建 Mount Pod 才生效?(提示:metaurl 是什么时候被读进挂载命令的)
  6. 为什么切换前要试 nc -zv $MASTER_IP 2379?生产上对应的检查是什么?
  7. playground 和 tiup cluster 部署的集群,运维上有什么本质区别?
蓝绿双槽本地模拟实验手册(不走流水线版)

目标:在你自己的测试集群里,从 Istio 安装开始,纯手工 kubectl 搭出一套和生产方案同构的蓝绿双槽环境,把"域名分流 + 网格同色"完整跑通。
不走流水线、不用 Helm chart,所有资源手写 —— 目的是让你看懂每个资源在干什么。
全程可随时推倒重来:kubectl delete ns blue-green 一键清场。

0. 你将搭出来的东西(最终形态)

公网域名分流(NodePort 模拟 Ingress)
  myapp.net  → blue 槽(页面 hello-world)
  myapp.com  → green 槽(页面 hello-green)
  带 x-test-routing: green 头的请求 → 强制预览 green

集群内同色调用(开 mesh 后)
  蓝调用方 Pod → 永远到 blue
  绿调用方 Pod → 永远到 green
  没颜色的调用方 → 兜底到 activeSlot(blue)

资源清单(全部手写)
  ns blue-green(打注入标签)
  Service myapp(selector 同时选中两槽)
  Deployment myapp-blue / myapp-green(version 标签 + 按槽 ConfigMap)
  ConfigMap myapp-config-blue / myapp-config-green(页面内容差异)
  ConfigMap myapp-slots(activeSlot / blue.tag / green.tag / net.subset)
  DestinationRule myapp(subsets blue/green)
  VirtualService myapp(公网)+ VirtualService myapp-mesh(网格)

1. 前提检查

kubectl get nodes                        # 集群可用(你 master + 2 node 的测试集群即可)
kubectl get ns blue-green 2>/dev/null    # 报 NotFound 最好;存在的话先 delete 清掉
端口约定:本实验用 NodePort 31080(公网入口)和 31081(内部直连,教学用)。如果 31080 被占了,全文统一换成别的空闲端口(30000-32767 之间)。检查:ss -tlnp | grep 31080(在 node 上执行,无输出=空闲)。

2. 安装 Istio(istioctl 方式)

# 2.1 下载 istioctl(版本选 1.22.x,和生产 1.30 同系行为一致;如想对齐生产可换 1.30.x)
cd ~
curl -L https://istio.io/downloadIstio | ISTIO_VERSION=1.22.5 sh -
cd istio-1.22.5
export PATH=$PWD/bin:$PATH
echo "export PATH=$PWD/bin:\$PATH" >> ~/.bashrc

# 2.2 验证
istioctl version          # client version 能显示即可(control plane 还没装,报连不上正常)

# 2.3 安装控制面(demo profile:含 istiod + ingressgateway,资源占用小)
istioctl install --set profile=demo -y

# 2.4 观察安装过程(约 1-3 分钟)
kubectl -n istio-system get pods -w
# 期望最终:
#   istiod-xxxxxxxxxx-xxxxx              1/1  Running
#   istio-ingressgateway-xxxxxxxxxx-x    1/1  Running

# 2.5 确认 istiod 是"默认版"(无修订名 → 用 istio-injection 标签体系)
kubectl -n istio-system get deploy | grep istiod
# 显示 istiod(而不是 istiod-1-22-5 这种带后缀的)= 默认版 ✓

# 2.6 把入口网关改成 NodePort(本地没有云 LB,这是必要改造)
kubectl -n istio-system patch svc istio-ingressgateway --type='json' -p='[
  {"op":"replace","path":"/spec/type","value":"NodePort"},
  {"op":"add","path":"/spec/ports/1/nodePort","value":31080}
]'
# ports[1] 一般是 80 端口项;改完验证:
kubectl -n istio-system get svc istio-ingressgateway
# 期望看到 80:31080/TCP

# 2.7 卸载方法(不需要执行,备查):
# istioctl uninstall --purge -y && kubectl delete ns istio-system

质量门 G1istiodistio-ingressgateway 都 Running,svc 显示 80:31080。不满足不要往下走。


3. 部署双槽应用(纯手工 YAML)

3.1 命名空间 + 按槽配置 + 记事本

kubectl create ns blue-green
# 注意:现在先不打注入标签(阶段 6 才开 mesh,对照实验)

kubectl -n blue-green create configmap myapp-config-blue \
  --from-literal=index.html='hello-world (BLUE)'

kubectl -n blue-green create configmap myapp-config-green \
  --from-literal=index.html='hello-green (GREEN)'

# 店长记事本(模拟 deploy.sh 维护的状态)
kubectl -n blue-green create configmap myapp-slots \
  --from-literal=activeSlot=blue \
  --from-literal=blue.tag=v1 \
  --from-literal=green.tag=v1 \
  --from-literal=net.subset=blue

3.2 一个 Service + 两套 Deployment

保存为 myapp.yaml 然后 kubectl apply -f myapp.yaml

# ── Service:selector 只认 app,同时选中蓝绿 ──
apiVersion: v1
kind: Service
metadata:
  name: myapp
  namespace: blue-green
spec:
  selector:
    app: myapp            # 故意不写 version
  ports:
  - port: 80
    targetPort: 80
---
# ── 蓝槽 ──
apiVersion: apps/v1
kind: Deployment
metadata:
  name: myapp-blue
  namespace: blue-green
spec:
  replicas: 1
  selector:
    matchLabels: { app: myapp, version: blue }
  template:
    metadata:
      labels:
        app: myapp
        version: blue     # 颜色标签:DR 分组和 mesh 同色都靠它
    spec:
      containers:
      - name: nginx
        image: nginx:1.25-alpine
        ports: [{ containerPort: 80 }]
        volumeMounts:
        - { name: page, mountPath: /usr/share/nginx/html }
      volumes:
      - name: page
        configMap: { name: myapp-config-blue }
---
# ── 绿槽:与蓝槽只有三处不同(名字/version/挂的 CM)──
apiVersion: apps/v1
kind: Deployment
metadata:
  name: myapp-green
  namespace: blue-green
spec:
  replicas: 1
  selector:
    matchLabels: { app: myapp, version: green }
  template:
    metadata:
      labels:
        app: myapp
        version: green
    spec:
      containers:
      - name: nginx
        image: nginx:1.25-alpine
        ports: [{ containerPort: 80 }]
        volumeMounts:
        - { name: page, mountPath: /usr/share/nginx/html }
      volumes:
      - name: page
        configMap: { name: myapp-config-green }

验证:

kubectl -n blue-green get pods -o wide
# myapp-blue-xxx    1/1 Running   (READY 1/1:还没注入,正常)
# myapp-green-xxx   1/1 Running

# 教学时刻:Service 现在同时选中两槽 → 内部访问是蓝绿轮询的
kubectl -n blue-green expose svc myapp --type=NodePort --name=myapp-direct --port=80 --node-port=31081
NODE1=<node1的内网IP>
curl -s http://$NODE1:31081/   # 多刷几次,hello-world 和 hello-green 交替出现
# 这就是文档说的"内部无 sidecar 时在蓝绿 Endpoint 间 round-robin"——记住这个现象
kubectl delete svc myapp-direct -n blue-green   # 看完就删,别留着干扰实验

质量门 G2:两 Pod Running;直连 Service 轮询现象已亲眼确认。


4. 公网分流:Gateway + DR + 公网 VS

保存为 istio-public.yaml 然后 kubectl apply -f istio-public.yaml

# ── Gateway:入口开 80 端口,接受两个域名 ──
apiVersion: networking.istio.io/v1beta1
kind: Gateway
metadata:
  name: myapp-gw
  namespace: blue-green
spec:
  selector:
    istio: ingressgateway        # 选中 istio-system 里的入口网关 Pod
  servers:
  - port: { number: 80, name: http, protocol: HTTP }
    hosts: ["myapp.net", "myapp.com"]
---
# ── DestinationRule:只声明两条路(subset),不写域名不写 Gateway ──
apiVersion: networking.istio.io/v1beta1
kind: DestinationRule
metadata:
  name: myapp
  namespace: blue-green
spec:
  host: myapp.blue-green.svc.cluster.local
  subsets:
  - name: blue
    labels: { version: blue }
  - name: green
    labels: { version: green }
---
# ── 公网 VS:只挂 Ingress Gateway ──
# 规则顺序:Header 预览 → .net authority → .com authority
apiVersion: networking.istio.io/v1beta1
kind: VirtualService
metadata:
  name: myapp
  namespace: blue-green
spec:
  hosts: ["myapp.net", "myapp.com"]
  gateways: ["myapp-gw"]
  http:
  - name: preview                # VIP 卡:优先级最高
    match:
    - headers: { x-test-routing: { exact: green } }
    route:
    - destination:
        host: myapp.blue-green.svc.cluster.local
        subset: green
  - name: net                    # .net 传单 → net.subset 记的槽(初始 blue)
    match:
    - authority: { exact: "myapp.net" }
    route:
    - destination:
        host: myapp.blue-green.svc.cluster.local
        subset: blue
  - name: com                    # .com 传单 → 写死 green(模拟生产"com 不动")
    match:
    - authority: { exact: "myapp.com" }
    route:
    - destination:
        host: myapp.blue-green.svc.cluster.local
        subset: green

验收(<node1内网IP> 换成你的):

NODE1=<node1的内网IP>

curl -s -H "Host: myapp.net" http://$NODE1:31080/    # 期望 hello-world (BLUE)
curl -s -H "Host: myapp.com" http://$NODE1:31080/    # 期望 hello-green (GREEN)
curl -s -H "Host: myapp.net" -H "x-test-routing: green" http://$NODE1:31080/
# 期望 hello-green (GREEN):Header 预览压过域名规则

质量门 G3:三条 curl 结果如上。失败排查:istioctl -n blue-green analyzekubectl -n istio-system logs deploy/istio-ingressgateway --tail=50


5. 模拟 switch / rollback(手动扮演 deploy.sh)

生产的 switch:test 改的是 slots CM 的 net.subset + 同步改 VS;这里你手动做同样的事:

# ── switch:.net 切到 green ──
kubectl -n blue-green patch configmap myapp-slots --type merge -p '{"data":{"net.subset":"green"}}'
kubectl -n blue-green patch vs myapp --type json \
  -p='[{"op":"replace","path":"/spec/http/1/route/0/destination/subset","value":"green"}]'

curl -s -H "Host: myapp.net" http://$NODE1:31080/    # 现在 → hello-green (GREEN)
curl -s -H "Host: myapp.com" http://$NODE1:31080/    # 不受影响,还是 GREEN(它本来就指 green)

# ── rollback:切回 blue ──
kubectl -n blue-green patch configmap myapp-slots --type merge -p '{"data":{"net.subset":"blue"}}'
kubectl -n blue-green patch vs myapp --type json \
  -p='[{"op":"replace","path":"/spec/http/1/route/0/destination/subset","value":"blue"}]'

curl -s -H "Host: myapp.net" http://$NODE1:31080/    # 回到 hello-world (BLUE)
思考:注意 CM 里的 activeSlot 全程没动过——这就是"问作者 5 条"里那个问题的实物版:switch 只改了 net.subset,activeSlot 没同步。如果 deploy.sh 靠 activeSlot 算非活跃槽,下次发版会发生什么?(答:发到正在接 .net 流量的 green 头上。)

质量门 G4:switch/rollback 即时生效,.com 全程无感。


6. 开 mesh:注入 + 网格 VS + 同色验收

6.1 打注入标签并重启

kubectl label ns blue-green istio-injection=enabled --overwrite
kubectl -n blue-green rollout restart deploy/myapp-blue deploy/myapp-green

kubectl -n blue-green get pods
# READY 2/2 = 应用 + istio-proxy 注入成功 ✓
# (如果还是 1/1:检查标签打对没有、istiod 是否 Running)

6.2 部署网格 VS(只挂 mesh,和公网 VS 分开)

保存为 istio-mesh.yaml 然后 kubectl apply -f istio-mesh.yaml

apiVersion: networking.istio.io/v1beta1
kind: VirtualService
metadata:
  name: myapp-mesh
  namespace: blue-green
spec:
  hosts: ["myapp.blue-green.svc.cluster.local"]
  gateways: ["mesh"]               # 保留字:只管 sidecar 间流量
  http:
  - name: from-blue                # 蓝调用方 → 蓝
    match:
    - sourceLabels: { version: blue }
    route:
    - destination:
        host: myapp.blue-green.svc.cluster.local
        subset: blue
  - name: from-green               # 绿调用方 → 绿
    match:
    - sourceLabels: { version: green }
    route:
    - destination:
        host: myapp.blue-green.svc.cluster.local
        subset: green
  - name: default                  # 无颜色调用方 → 兜底 activeSlot(blue)
    route:
    - destination:
        host: myapp.blue-green.svc.cluster.local
        subset: blue

6.3 验收一:sidecar 按颜色过滤路由

kubectl -n blue-green exec deploy/myapp-blue -c istio-proxy -- \
  curl -s localhost:15000/config_dump | grep -o '"name": "myapp-[^"]*"' | sort | uniq -c
# 期望只看到 from-blue(没有 from-green = 正常裁剪,不是漏配)

kubectl -n blue-green exec deploy/myapp-green -c istio-proxy -- \
  curl -s localhost:15000/config_dump | grep -o '"name": "myapp-[^"]*"' | sort | uniq -c
# 期望只看到 from-green

6.4 验收二:探针实测同色(建→测→删)

kubectl -n blue-green run mesh-probe-blue --image=curlimages/curl --restart=Never \
  --labels=version=blue --command -- sleep 3600
kubectl -n blue-green run mesh-probe-green --image=curlimages/curl --restart=Never \
  --labels=version=green --command -- sleep 3600
kubectl -n blue-green get pod -l run --field-selector=status.phase=Running -w   # 等两个 2/2 Running

kubectl -n blue-green exec mesh-probe-blue -- \
  curl -s http://myapp.blue-green.svc.cluster.local/     # 刷几次都应是 hello-world (BLUE)
kubectl -n blue-green exec mesh-probe-green -- \
  curl -s http://myapp.blue-green.svc.cluster.local/     # 刷几次都应是 hello-green (GREEN)

# 教学对照:无颜色探针 → 兜底到 activeSlot(blue)
kubectl -n blue-green run mesh-probe-plain --image=curlimages/curl --restart=Never \
  --command -- sleep 3600
kubectl -n blue-green exec mesh-probe-plain -- \
  curl -s http://myapp.blue-green.svc.cluster.local/     # 期望 hello-world (BLUE)

# 测完即删
kubectl -n blue-green delete pod mesh-probe-blue mesh-probe-green mesh-probe-plain

质量门 G5:蓝探针只见蓝、绿探针只见绿、无色探针兜底蓝。至此全套双栈并行跑通。


7. 教学对照实验(选做但强烈建议)

7.1 从 sidecar 容器里 curl(演示"错误验收方式")

kubectl -n blue-green run mesh-probe-blue --image=curlimages/curl --restart=Never \
  --labels=version=blue --command -- sleep 3600

# 错误示范:从 istio-proxy 容器里发请求(绕过 Envoy,直连 Service 轮询)
kubectl -n blue-green exec mesh-probe-blue -c istio-proxy -- \
  curl -s http://myapp.blue-green.svc.cluster.local/
# 多刷几次:蓝绿随机出现!因为流量没进 Envoy 的规则体系
# 结论:mesh 验收永远从应用容器发请求

kubectl -n blue-green delete pod mesh-probe-blue

7.2 合并 VS 翻车(演示生产文档的头号坑)

把公网和 mesh 规则合并成一条 VS(错误示范):

kubectl -n blue-green delete vs myapp-mesh
kubectl -n blue-green patch vs myapp --type json -p='[
  {"op":"replace","path":"/spec/gateways","value":["myapp-gw","mesh"]},
  {"op":"add","path":"/spec/http/0","value":{
    "name":"from-green",
    "match":[{"sourceLabels":{"version":"green"}}],
    "route":[{"destination":{"host":"myapp.blue-green.svc.cluster.local","subset":"green"}}]
  }}
]'
# 然后重新建探针测试内部调用,观察是不是"内部全绿/颜色混乱"
# 域名分流(公网)可能依然正常 → 最容易误判成"没问题"
# 玩完恢复:kubectl delete ns blue-green 后从第 3 章重来(最快)

8. 观察与排错命令备查

istioctl -n blue-green analyze                          # 配置体检(第一排错工具)
kubectl -n blue-green get gw,vs,dr                      # 看网格资源
kubectl -n istio-system logs deploy/istiod --tail=50    # 控制面日志
kubectl -n istio-system logs deploy/istio-ingressgateway --tail=50   # 入口日志
kubectl -n blue-green exec deploy/myapp-blue -c istio-proxy -- \
  curl -s localhost:15000/config_dump | head -100       # sidecar 实际收到的配置

9. 清场

kubectl delete ns blue-green
# 连 Istio 也一起卸掉(不想留的话):
# istioctl uninstall --purge -y && kubectl delete ns istio-system

10. 本实验 ↔ 生产方案对照表

本实验(手工模拟)生产方案(平台自动化)
手写 Deployment×2 / Service / DR / VSgeneric-service chart ≥1.1.2 渲染,values 开 blueGreen
你手动 patch VS + CM 模拟 switch手动 job switch:test 改 net.subset
你手动改 CM 的槽 tagdeploy.sh --inactive-slot 自动算非活跃槽并更新
NodePort + curl Host 头模拟域名真实 Ingress Gateway + 真实 .net/.com 域名
ConfigMap 挂页面当"按槽配置"APPLICATION_YAML File 变量按槽拆(生产要自己设计)
nginx 无状态随便切真服务要考虑库表只加不改、HPA/PDB 按槽、优雅退出
istioctl demo profileVKE 生产网格(Istio 1.30 系,可能托管)
注入标签 istio-injection(默认版 istiod)生产要先查 webhook namespaceSelector 确认标签体系

11. 实验自查题(做完能答才算会)

  1. 为什么 Service 的 selector 不能写 version?
  2. 直连 Service(31081)为什么是轮询,开了 mesh 之后探针访问为什么就固定颜色了?(提示:谁拦下了流量)
  3. DR 和 VS 各负责什么?为什么 subset 用 version 标签而不用镜像 tag?
  4. 为什么 kubectl exec -c istio-proxy -- curl 测不出 mesh 分流?
  5. 合并 VS 后故障现象为什么是"域名正常、内部全绿"?
  6. myapp-slots CM 里 activeSlot 和 net.subset 分别被谁读?不同步会怎样?

JuiceFS 生产迁移执行手册(纯命令版·无变量)

使用前提:调研完成、演练完成、窗口已批准。
用法:先在 §0 把每个 <占位符> 的真实值查好写在旁边 → 执行时整条命令复制、替换尖括号再敲。
每条命令自包含,换终端、换窗口都不受影响。每段【GATE】不通过 → 立即走 §7 对应段回滚,不硬闯。
场景标记:【K8s】= CSI 挂载环境;【宿主】= 宿主机 FUSE 挂载环境;都有就都执行。

0. 占位符对照表(执行前全部填好)

占位符填什么去哪查
<REDIS密码>元数据引擎密码CSI Secret metaurl 解码 / 宿主机挂载进程
<REDIS地址> <REDIS端口> <REDIS_DB>Redis 地址/端口/库号同上,如 xxx:6379 0
<PD1_IP> <PD2_IP> <PD3_IP>三台 TiKV 节点 ECS 内网 IP云控制台
<前缀>TiKV 命名前缀,默认 jfs与演练验证过的一致
<REDIS_NS> <REDIS_POD>Redis 所在命名空间/Pod 名`kubectl get pods -A \grep redis`(集群内场景)
<MOUNT_POD>任一 Mount Pod 名kubectl -n <NS> get pod -l app.kubernetes.io/name=juicefs-mount
<SECRET命名空间> <SECRET名1/2/3>所有含 metaurl 的 CSI Secret逐个 PV 查 nodePublishSecretRef + SC 查
<业务NS> <业务DEPLOY名> <原副本数>全部使用该文件系统的业务`kubectl describe pvc \grep "Used By"`
<挂载点> <挂载参数>宿主机挂载点和完整参数`ps aux \grep "juicefs mount"` 原样抄
<业务服务名>宿主机上业务进程名systemctl / supervisor / compose
<AK> <SK>对象存储密钥Secret 解码 / 云平台
<SSH密码>ECS 的 SSH 密码自有记录

1. 部署 TiKV 集群(窗口前完成,ECS ×3)

# 1.1 三台 ECS 系统初始化(每台都执行)
echo never > /sys/kernel/mm/transparent_hugepage/enabled
echo never > /sys/kernel/mm/transparent_hugepage/defrag
echo 'vm.swappiness = 0' >> /etc/sysctl.conf && sysctl -p
mkfs.ext4 /dev/vdb && mkdir -p /data && mount /dev/vdb /data
echo '/dev/vdb /data ext4 nodelalloc,noatime 0 0' >> /etc/fstab && df -h /data

# 1.2 中控机装 tiup(任选一台能 ssh 到三台 ECS 的机器)
curl --proto '=https' --tlsv1.2 -sSf https://tiup-mirrors.pingcap.com/install.sh | sh
source ~/.bash_profile 2>/dev/null || source ~/.bashrc

# 1.3 拓扑:PD×3 + TiKV×3 + 监控(不装 TiDB),生成后按实际 IP 改
tiup cluster template --minimal > topo.yaml
# 编辑 topo.yaml:pd_servers 填三台 IP、tikv_servers 填三台 IP、monitoring/grafana 填其中一台

tiup cluster check ./topo.yaml --user root -p '<SSH密码>'        # 有 fail 项全部修完再往下
tiup cluster deploy jfs-tikv v8.1.0 ./topo.yaml --user root -p '<SSH密码>'
tiup cluster start jfs-tikv --init
tiup cluster display jfs-tikv                                    # 全部 Up

【GATE-1】display 全 Up;df -h /data 是独立盘;从任一客户端机器 nc -zv <PD1_IP> 2379 通(安全组已对客户端网段放行 2379/2380/20160)。


2. T-1 备份(窗口前一天)

mkdir -p ~/jfs-migration && cd ~/jfs-migration

# 【K8s】2.1 备份全部 CSI Secret(有几个写几行)
kubectl -n <SECRET命名空间> get secret <SECRET名1> -o yaml > secret-<SECRET名1>.yaml
kubectl -n <SECRET命名空间> get secret <SECRET名2> -o yaml > secret-<SECRET名2>.yaml
kubectl -n <SECRET命名空间> get secret <SECRET名3> -o yaml > secret-<SECRET名3>.yaml
ls -la                                          # 确认每个文件非空

# 【宿主】2.2 备份 fstab + 挂载参数
grep -i juicefs /etc/fstab > fstab.bak
ps aux | grep "juicefs mount" | grep -v grep > mount-cmd.bak
mount | grep -i juicefs >> mount-cmd.bak

# 2.3 Redis 落盘备份(两种通道按环境选一种)
# 通道一:Redis 在 K8s 里
kubectl -n <REDIS_NS> exec <REDIS_POD> -- sh -c "redis-cli -a '<REDIS密码>' --no-auth-warning save && cat /data/dump.rdb | base64" | base64 -d > redis-backup.rdb
# 通道二:云 Redis / 直连
redis-cli -h <REDIS地址> -p <REDIS端口> -a '<REDIS密码>' --no-auth-warning --rdb redis-backup.rdb
ls -lh redis-backup.rdb                         # 非空

# 2.4 客户端版本(≥1.3.0 才能 --binary,低了去掉 --binary 改用 meta-prod.json)
kubectl -n <NS> exec <MOUNT_POD> -- juicefs version

【GATE-2】备份文件齐全非空;版本达标。


3. T0 停写(窗口开始)

# 【K8s】3A.1 缩容全部业务(有几个写几行)
kubectl -n <业务NS> scale deploy <业务DEPLOY名1> --replicas=0
kubectl -n <业务NS> scale deploy <业务DEPLOY名2> --replicas=0

# 【K8s】3A.2 确认 Mount Pod 全部消失(CSI 按需创建,业务停了挂载即释放)
watch kubectl get pods -A | grep juicefs-mount          # 等到输出为空,Ctrl+C 退出

# 【宿主】3B.1 停业务 + 卸载
systemctl stop <业务服务名>
umount <挂载点>
mount | grep -i juicefs                                 # 无输出 = 干净

4. 三道闸(全绿才能导)

# 闸1:Sessions 为空
kubectl -n <NS> exec <MOUNT_POD所在NS的任一含客户端Pod> -- juicefs status 'redis://:<REDIS密码>@<REDIS地址>:<REDIS端口>/<REDIS_DB>'
# 输出中 Sessions 段必须没有任何条目
# (Mount Pod 已随停写消失时:在执行机上直接跑 juicefs status 同命令)

# 闸2:写计数两次采样不涨(间隔 30 秒,人工对比两次输出一致)
kubectl -n <REDIS_NS> exec <REDIS_POD> -- redis-cli -a '<REDIS密码>' --no-auth-warning info stats | grep -E 'total_writes|instantaneous_ops'
sleep 30
kubectl -n <REDIS_NS> exec <REDIS_POD> -- redis-cli -a '<REDIS密码>' --no-auth-warning info stats | grep -E 'total_writes|instantaneous_ops'
# total_writes 差值 = 0 且 ops ≈ 0

# 闸3:业务方书面确认全部停写(群里文字确认,截图留证)

【GATE-3】三道全过。闸1/闸2 不过 → 找出还在写的客户端处理掉重新过闸;找不到就回滚(§7.0)。

5. 正式 dump + load + 验证

# 5.1 导出(一致性版本。K8s 内:迁移 Pod 里跑;集群外:执行机直接跑)
time juicefs dump 'redis://:<REDIS密码>@<REDIS地址>:<REDIS端口>/<REDIS_DB>' /tmp/meta-prod.zstd --binary --keep-secret-key

# 5.2 校验 + 双异地备份
md5sum /tmp/meta-prod.zstd
kubectl cp <NS>/juicefs-migrator:/tmp/meta-prod.zstd ~/jfs-migration/meta-prod.zstd    # Pod 场景
cp /tmp/meta-prod.zstd ~/jfs-migration/                                                # 执行机场景
# 再拷一份到第二台机器:scp ~/jfs-migration/meta-prod.zstd root@<另一台机器IP>:~/

# 5.3 导入 TiKV
time juicefs load 'tikv://<PD1_IP>:2379,<PD2_IP>:2379,<PD3_IP>:2379/<前缀>' /tmp/meta-prod.zstd
# 中断处理:tiup cluster display jfs-tikv 定位 → 修复 →(新集群可 destroy 重建)→ 用同一份文件重试

# 5.4 补密钥(5.1 没带 --keep-secret-key 时才执行)
juicefs config 'tikv://<PD1_IP>:2379,<PD2_IP>:2379,<PD3_IP>:2379/<前缀>' --access-key '<AK>' --secret-key '<SK>'

# 5.5 验证四件套
juicefs fsck 'tikv://<PD1_IP>:2379,<PD2_IP>:2379,<PD3_IP>:2379/<前缀>' /
juicefs ls -R 'tikv://<PD1_IP>:2379,<PD2_IP>:2379,<PD3_IP>:2379/<前缀>' / > /tmp/new-list.txt
juicefs ls -R 'redis://:<REDIS密码>@<REDIS地址>:<REDIS端口>/<REDIS_DB>' / > /tmp/old-list.txt
wc -l /tmp/new-list.txt /tmp/old-list.txt              # 行数必须一致
diff <(head -50 /tmp/new-list.txt) <(head -50 /tmp/old-list.txt)   # 抽样比对无输出=一致

【GATE-4】fsck 无 ERROR、条目数一致、抽样无差异。不过 → §7.1 回滚。

6. 切换 + 拉起

# 【K8s】6A.1 生成新 metaurl 的 base64(复制输出备用)
echo -n 'tikv://<PD1_IP>:2379,<PD2_IP>:2379,<PD3_IP>:2379/<前缀>' | base64 -w0; echo

# 【K8s】6A.2 patch 全部 CSI Secret(有几个写几行,<上一步的base64>原样粘贴)
kubectl -n <SECRET命名空间> patch secret <SECRET名1> --type merge -p '{"data":{"metaurl":"<上一步的base64>"}}'
kubectl -n <SECRET命名空间> patch secret <SECRET名2> --type merge -p '{"data":{"metaurl":"<上一步的base64>"}}'
kubectl -n <SECRET命名空间> patch secret <SECRET名3> --type merge -p '{"data":{"metaurl":"<上一步的base64>"}}'

# 【K8s】6A.3 抽查确认(应显示 tikv://...)
kubectl -n <SECRET命名空间> get secret <SECRET名1> -o jsonpath='{.data.metaurl}' | base64 -d; echo

# 【K8s】6A.4 拉起业务(CSI 自动用新 metaurl 重建 Mount Pod)
kubectl -n <业务NS> scale deploy <业务DEPLOY名1> --replicas=<原副本数>
kubectl -n <业务NS> scale deploy <业务DEPLOY名2> --replicas=<原副本数>
sleep 20 && kubectl get pods -A | grep juicefs-mount    # 新 Mount Pod 出现

# 【K8s】6A.5 验证:挂载命令行已是 tikv://;业务读写正常
kubectl -n <NS> get pod -l app.kubernetes.io/name=juicefs-mount
kubectl -n <NS> exec <新MOUNT_POD> -- sh -c "cat /proc/1/cmdline | tr '\0' ' '; echo"

# 【宿主】6B.1 原参数 + 新 URL 重挂(<挂载参数>逐字沿用 mount-cmd.bak)
juicefs mount 'tikv://<PD1_IP>:2379,<PD2_IP>:2379,<PD3_IP>:2379/<前缀>' <挂载点> <挂载参数> &
sleep 3 && mount | grep -i juicefs

# 【宿主】6B.2 改 fstab(用编辑器把 redis:// 那行的地址整段换成 tikv:// 新地址)
vi /etc/fstab

# 【宿主】6B.3 拉起业务 + 读写验证
systemctl start <业务服务名>
ls <挂载点>
echo 切换验证 > <挂载点>/.migration-test && cat <挂载点>/.migration-test && rm <挂载点>/.migration-test

【GATE-5】挂载指向 TiKV、业务读写正常、业务方确认。不过 → §7.2 回滚。


7. 回滚(按所处阶段选一段执行)

# 7.0 闸口未过 / 停写未完成:恢复业务即可(Redis 没动过)
kubectl -n <业务NS> scale deploy <业务DEPLOY名1> --replicas=<原副本数>

# 7.1 dump/load/验证失败(还没改 Secret/没重挂):同 7.0,业务回 Redis 零影响

# 7.2 已切换后失败:
# 【K8s】缩容 → 从备份恢复 Secret → 拉起 → 确认回到 redis://
kubectl -n <业务NS> scale deploy <业务DEPLOY名1> --replicas=0
kubectl replace -f ~/jfs-migration/secret-<SECRET名1>.yaml --force
kubectl replace -f ~/jfs-migration/secret-<SECRET名2>.yaml --force
kubectl -n <业务NS> scale deploy <业务DEPLOY名1> --replicas=<原副本数>
kubectl -n <NS> exec <MOUNT_POD> -- sh -c "cat /proc/1/cmdline | tr '\0' ' '; echo"

# 【宿主】卸载 → 挂回 Redis → 恢复 fstab → 拉起
umount <挂载点>
juicefs mount 'redis://:<REDIS密码>@<REDIS地址>:<REDIS端口>/<REDIS_DB>' <挂载点> <挂载参数> &
cp ~/jfs-migration/fstab.bak /etc/fstab
systemctl start <业务服务名>
# 注意:切换期间写入 TiKV 的新数据不随回滚带回,先和业务确认窗口内有无写入

8. 观察期(T+1 ~ T+14,每日)

tiup cluster display jfs-tikv                                   # 节点全 Up
kubectl get pods -A | grep -v Running                           # 无异常(K8s 场景)
kubectl -n <NS> logs <MOUNT_POD> --tail=100 | grep -iE 'error'  # 无持续增长报错
juicefs status 'tikv://<PD1_IP>:2379,<PD2_IP>:2379,<PD3_IP>:2379/<前缀>'
ssh <PD1_IP> 'iostat -x 1 3'                                    # TiKV 磁盘 util 不饱和
# 另看 Grafana:TiKV CPU/内存/磁盘延迟/Leader 分布

9. 收尾(观察期满)

# 9.1 TiKV 节点遗留清理(如经历过 destroy 重建)
ssh <PD1_IP> 'rm -rf /data/tikv-old /data/pd-old 2>/dev/null'

# 9.2 Redis 下线(确认无回滚需求后;先停,rdb 备份留 ≥1 个月再删资源)
kubectl -n <REDIS_NS> scale statefulset <REDIS_POD去掉-0> --replicas=0     # 集群内场景
# 云 Redis:控制台退订前先导出备份

# 9.3 归档:dump 文件 + md5 + Secret 备份 + 各 GATE 输出截图 → 变更记录归档
ls -la ~/jfs-migration/

Dagster 入门指南:现代数据编排框架

一、什么是 Dagster

Dagster 是一个用 Python 编写的开源数据编排平台,专为现代数据团队设计。它不只是一个"定时跑任务"的调度器,而是一个完整的数据开发环境,将管道定义、调度执行、监控告警和故障处理整合在一起。

核心哲学:从"任务优先"到"资产优先"

理解 Dagster 的关键,在于理解它和传统工具看世界的角度不同

传统工作流工具(以 Apache Airflow 为代表)关心的是任务——"先跑 A,再跑 B,然后跑 C"。至于这些任务产出了什么数据、数据之间有什么关系,它不太关心,需要你自己在脑子里维护。

Dagster 关心的是数据资产——"用户表是由订单表聚合而来的,报表又依赖用户表"。你声明资产之间的依赖关系,Dagster 自动推导执行顺序。整个数据血缘图,它自己就拼出来了,不用你手动连线。

打个比方:Airflow 像是一个"任务清单管家",它确保你按顺序把事情做完;Dagster 则像一个"数据地图",它不仅知道你要做什么,更知道每件事产出了什么、下游谁在用。

二、核心概念

2.1 资产(Assets)—— 最核心的概念

在 Dagster 中,资产就是你的数据产物——可以是数据库表、CSV 文件、机器学习模型,甚至是报表 PDF。用 @asset 装饰器声明一个资产,函数参数就是它的上游依赖:

from dagster import asset

@asset
def raw_orders():
    """从数据库拉取原始订单"""
    return fetch_from_db("orders")

@asset
def daily_summary(raw_orders):  # 参数名 = 上游资产名,依赖关系一目了然
    """基于原始订单生成每日汇总"""
    return raw_orders.groupby("date").agg({"amount": "sum"})

Dagster 看到 daily_summary(raw_orders) 就知道:要更新汇总表,得先有原始订单。这种声明式依赖让数据血缘追踪变得异常简单。

2.2 Ops 和 Graphs —— 传统任务编排方式

虽然资产是核心,Dagster 也兼容传统的任务编排模式:

  • Op:可复用的计算单元,类似 Airflow 的 Operator
  • Graph:将多个 Op 连接成完整的工作流(有向无环图)
from dagster import op, graph, Out

@op
def extract():
    return fetch_data()

@op
def transform(raw_data):
    return clean(raw_data)

@op
def load(clean_data):
    write_to_db(clean_data)

@graph
def etl_pipeline():
    load(transform(extract()))

2.3 软件定义资产(SDA)—— 创新的设计

Software-Defined Assets 是 Dagster 的一大创新:它将数据产物和生成这些产物的代码直接关联。每个资产不仅知道"自己是什么",还知道"自己是怎么来的"。这让数据血缘、版本追踪和依赖管理变得异常简单。

2.4 资产检查(Asset Checks)—— 内建数据质量

Dagster 允许给资产挂上质量断言,物化(执行)时自动校验:

from dagster import asset, AssetCheckResult

@asset
def user_table():
    return load_users()

@asset(check_specs=[
    AssetCheckSpec(name="no_empty_names", asset="user_table")
])
def check_user_table(user_table):
    empty_count = user_table["name"].isna().sum()
    return AssetCheckResult(
        passed=empty_count == 0,
        metadata={"empty_names": empty_count}
    )

2.5 Components(v1.11+)—— 低代码构建块

从 v1.11 开始,Dagster 引入了 Components 机制:用 YAML 或轻量 Python 定义可复用的管道构建块。比如引入 dbt 项目,只需几行配置:

type: dagster_dbt.DbtProjectComponent
attributes:
  project: "{{ project_root }}/dbt"
  select: "customers"

Dagster 会根据配置自动生成所有资产,大幅减少样板代码。内置的 Components 覆盖了 dbt、Fivetran、Airbyte、Sling、dlt、Power BI 等常见工具$TRAE_REF

三、Dagster 与其他框架的对比

3.1 Dagster vs Airflow

维度AirflowDagster
核心模型任务优先(DAG + Operator)资产优先(Asset + 声明式依赖)
数据血缘需手动维护,依赖图复杂时混乱自动生成,函数参数即依赖关系
重跑机制手动梳理下游,容易遗漏自动识别受影响资产,按依赖顺序重跑
类型系统弱类型,任务间传参靠 XCom强类型,支持类型注解和编译期检查
本地开发本地和线上行为有差异,调试困难本地完整运行,测试体验好
数据质量需额外集成 Great Expectations 等内建 Asset Checks
UI 可视化任务 DAG 图资产血缘图 + 执行历史 + 日志追踪

很多从 Airflow 迁移过来的团队反馈:最大的变化不是功能多寡,而是心智负担的减轻——依赖关系不再需要手动维护,重跑不再需要自己画图梳理,数据血缘可视化是白送的$TRAE_REF

3.2 Dagster vs Prefect

两者都是现代化的 Python 原生工作流框架,但定位有差异:

  • Prefect 更强调弹性(自动重试、断点续跑),适合"任务编排"场景
  • Dagster 更强调资产管理和可观测性,适合"数据工程"场景

选型建议:如果团队关注的是"数据产出了什么、谁在用",选 Dagster;如果关注的是"任务失败后怎么自动恢复",选 Prefect。

四、为什么选择 Dagster

4.1 开发体验

全 Python API,类型提示,本地开发环境和测试框架——你可以在提交到生产环境之前,在本地完整运行和调试管道。对于习惯了软件工程最佳实践的数据工程师来说,这种体验是降维打击。

4.2 资产感知

这是 Dagster 与传统工具最根本的区别。传统工具关心"任务有没有跑完",Dagster 关心"数据是不是最新的"。这种模式更符合数据工程师的思维方式——我们最终关心的是数据产物,而不仅仅是任务执行

4.3 强大的调试和可观测性

Dagster 的 Web UI(Dagit)提供了:

  • 资产依赖图:一眼看清整条数据链路
  • 数据血缘追踪:从源表到报表,上下游一目了然
  • 执行历史:每次运行的详细日志和状态
  • 错误定位:精准定位失败步骤,支持单步重跑

4.4 灵活的部署选项

  • 本地开发:pip install dagster 即可
  • 自托管:Docker、Kubernetes
  • 云服务:Dagster Cloud(含 Serverless 和 Hybrid 模式)

五、实战:构建一个完整的 ETL 流程

下面用 Dagster 实现一个从 CSV 提取 → 清洗转换 → 写入数据库的完整 ETL 管道:

import pandas as pd
from dagster import asset, job, Definitions, ScheduleDefinition

# ========== 定义资产 ==========

@asset
def raw_sales_data():
    """资产1:从 CSV 提取原始销售数据"""
    df = pd.read_csv("data/sales_2024.csv")
    return df

@asset
def cleaned_sales(raw_sales_data):
    """资产2:清洗数据(依赖 raw_sales_data)"""
    df = raw_sales_data.copy()
    # 去除空值
    df = df.dropna(subset=["order_id", "amount"])
    # 金额转正数
    df["amount"] = df["amount"].abs()
    return df

@asset
def daily_report(cleaned_sales):
    """资产3:生成日报(依赖 cleaned_sales)"""
    report = (
        cleaned_sales
        .groupby("date")
        .agg(
            total_orders=("order_id", "count"),
            total_amount=("amount", "sum"),
            avg_amount=("amount", "mean")
        )
        .reset_index()
    )
    report.to_csv("output/daily_report.csv", index=False)
    return report

# ========== 组装定义 ==========

defs = Definitions(
    assets=[raw_sales_data, cleaned_sales, daily_report],
    jobs=[define_asset_job("etl_job", selection="*")],
    schedules=[
        ScheduleDefinition(
            job=define_asset_job("daily_etl", selection="*"),
            cron_schedule="0 6 * * *",  # 每天早上6点
        )
    ],
)

启动:

pip install dagster dagit
dagster dev -f etl_pipeline.py

然后访问 http://localhost:3000,就能看到资产依赖图和执行面板。

六、高级特性

6.1 分区与回填

数据工程中常需要按时间分区处理数据,Dagster 对此有原生支持:

from dagster import asset, DailyPartitionsDefinition

@asset(
    partitions_def=DailyPartitionsDefinition(start_date="2024-01-01")
)
def daily_sales(context):
    partition_date = context.partition_key  # 如 "2024-03-15"
    return fetch_sales_for_date(partition_date)

在 UI 中可以选择任意日期范围进行回填,Dagster 会自动按分区逐个执行。

6.2 资源管理

数据库连接、API 客户端等外部依赖通过 Resources 统一管理,测试时可注入模拟资源:

from dagster import asset, resource, Definitions

@resource
def database_client():
    return create_db_connection()

@asset(required_resource_keys={"db"})
def user_table(context):
    return context.resources.db.query("SELECT * FROM users")

defs = Definitions(
    assets=[user_table],
    resources={"db": database_client},
)

6.3 声明式自动化(Declarative Automation)

这是 Dagster 近年推出的重要特性。传统编排是"我告诉你什么时候跑什么",声明式自动化是"我告诉你数据应该是什么状态,Dagster 自己判断什么时候该跑、跑什么"。你定义期望的资产新鲜度,Dagster 持续监控并在需要时自动触发物化$TRAE_REF

七、实际应用场景

数据仓库 ETL/ELT

Dagster 的资产模型与 dbt 天然契合——dbt 的每个 model 对应一个资产,Dagster 自动追溯表之间的血缘关系。Vanta 从 Airflow 迁移到 Dagster 后,关键业务数据的新鲜度从 7 小时缩短到 30 分钟以内$TRAE_REF

机器学习管道

从数据准备、特征工程到模型训练和评估,Dagster 可以管理整个 ML 生命周期,并追踪每个步骤产出的数据和模型版本。

报表生成系统

当报表之间有复杂依赖关系(比如月报依赖周报,周报依赖日报),Dagster 的资产依赖图能让整个系统一目了然,新增报表只需声明它依赖哪些上游数据即可。

八、入门建议

  1. 安装pip install dagster dagit 即可开始
  2. 先理解核心概念:资产(Asset)、Op、Job 是三个最重要的基础概念
  3. 从小项目开始:不要一上来就构建复杂系统,先用一个简单的 ETL 流程跑通
  4. 善用本地开发dagster dev 一键启动本地环境,边写边测
  5. 渐进式迁移:如果已有 Airflow,不必一次性全搬。Dagster 可以集成现有 Airflow 实例,新管道用 Dagster、老旧管道逐步迁移
  6. 利用社区资源:Dagster 有活跃的 Slack 社区和详细的官方文档,遇到问题很容易找到答案

总结

Dagster 的根本创新在于将数据编排的关注点从"任务"转向"资产"。这种视角转换带来的不仅是技术上的便利(自动血缘、智能重跑、内建数据质量),更是一种思维方式的改变——数据工程师真正关心的,从来都是数据本身,而不是搬运数据的管道。

如果你正在开始一个新项目,或者被 Airflow 的复杂依赖和重跑搞得焦头烂额,Dagster 值得认真考虑。

image.png

Istio 入门指南:云原生服务网格实战

一、什么是 Istio

1.1 先理解 Service Mesh

在认识 Istio 之前,需要先了解一个概念:Service Mesh(服务网格)

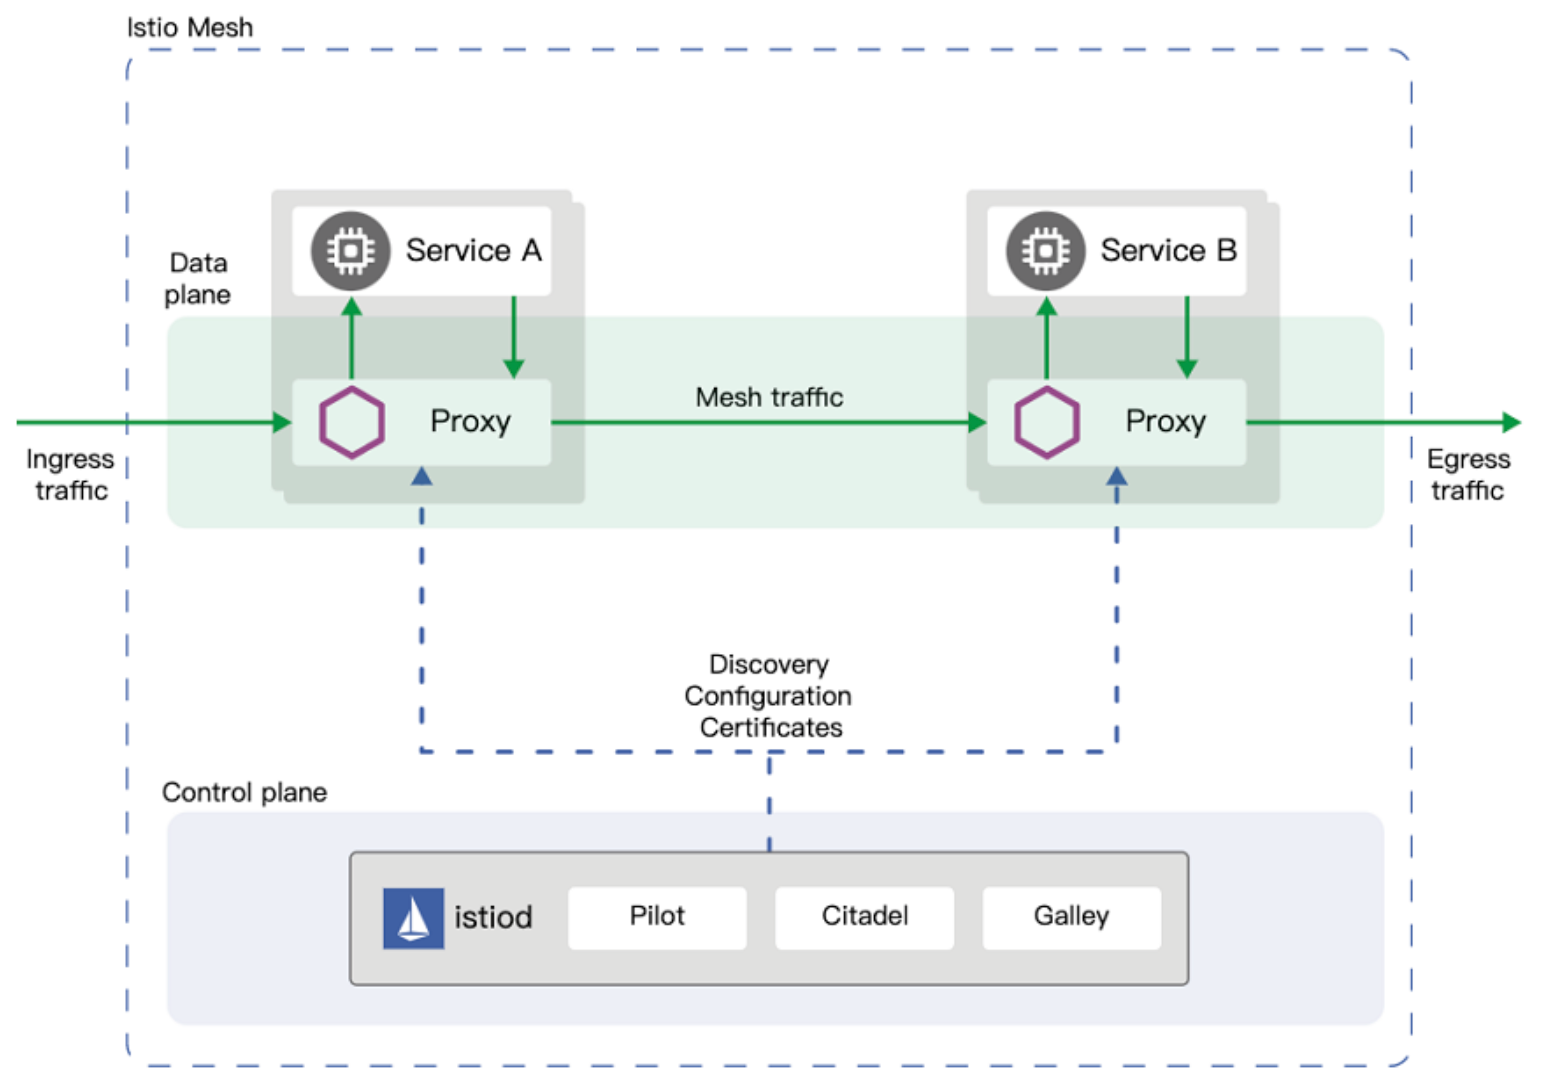
服务网格是一个独立的基础设施层,专门处理微服务之间的通信。它的工作方式是:在每个服务旁边部署一个轻量级网络代理(Sidecar),所有进出服务的流量都经过这个代理,由代理统一处理服务发现、负载均衡、加密、限流、监控等事务。业务代码完全不需要感知这些,真正做到了零侵入。

Istio 是目前最主流的 Service Mesh 实现,由 Google、IBM 和 Lyft 于 2017 年联合推出。它的设计目标很明确:在 Kubernetes 之上,以非侵入的方式为微服务提供流量管理、安全加固、服务监控和策略管理能力。

1.2 传统微服务 vs Istio 微服务

传统 Spring Cloud 微服务项目中,每个服务都需要引入 SDK(如 Ribbon、Hystrix、Sleuth 等),业务代码和治理逻辑耦合在一起运行。而基于 Istio 的微服务架构中,治理逻辑被下沉到 Sidecar 代理中,业务代码只管写业务逻辑,通信的事交给代理。

这种架构变化带来的好处是:

  • 业务代码和治理逻辑彻底解耦,各自独立升级
  • 不再受编程语言限制——Java、Go、Python、Node.js 都能用同一套治理方案
  • 对已有系统可以渐进式改造,先给部分服务接入 Sidecar 即可

二、Istio 的四大核心能力

Istio 官方将自己的能力概括为四个关键词:连接(Connect)、安全(Secure)、策略(Control)、观察(Observe)

2.1 连接——流量管理

微服务数量一多,服务间的调用关系就变得错综复杂。在一个典型的场景中,可能存在以下需求:

  • 同一服务的不同版本需要对外提供不同功能(比如 v1 是稳定版,v2 是灰度版)
  • 不同用户身份访问同一服务时,需要路由到不同版本
  • 网格内部的服务之间需要按调用方、被调用方、请求内容等条件进行路由
  • 需要处理网络故障、服务故障时的降级和重试

Istio 的流量管理能力解决的就是这些问题,具体包括:

  • 服务注册与发现:网格中的每个服务和版本都能被准确标识,互相查找
  • 负载均衡:支持多种策略(轮询、随机、最小连接数等),适配不同场景
  • 动态流量分配:根据流量特征,在不同版本之间灵活引导流量
  • 出站/入站控制:管理网格内部访问外部服务的流量,以及外部用户进入网格的流量

2.2 安全——零信任通信

在容器云环境中,大量 Pod 在集群中漂移,传统基于 IP 的防火墙策略难以应对。同时,不同语言实现的微服务要做到一致的访问控制也困难重重。

Istio 的安全能力在不修改业务代码的前提下提供:

  • 服务间通信加密(mTLS):防止流量被窃听
  • 服务身份认证:只有持有有效身份的客户端才能访问指定服务
  • 细粒度访问控制:支持基于服务身份、请求路径、请求头等条件的授权策略

这些能力背后依赖一套完整的证书管理体系(CA),负责证书的签发、传播和更新。

2.3 策略——可插拔的管控

Istio 支持通过可动态插拔的策略来实现访问控制、速率限制、配额管理等功能。在 Istio 的早期架构中,Mixer 组件负责策略执行——每次 Envoy 代理的调用都会经过 Mixer 进行预检和事后报告,从而实现对流量的部分控制能力。在后续版本中,这些功能逐渐内聚到 Envoy 自身,架构更加精简。

2.4 观察——全方位的可观测性

随着服务数量增加,监控和追踪的需求也水涨船高。在微服务体系中,我们更关注的是高层次的服务健康状态,而不仅仅是单台机器的 CPU 和内存。具体来说:

  • 指标监控:服务的调用成功率、响应时间、调用量、传输量等
  • 分布式链路追踪:跟踪一次请求在多个服务之间的完整调用链路
  • 日志收集:统一采集和输出服务运行日志

这些数据配合可视化工具(如 Grafana、Jaeger、Kiali),能让运维人员快速了解服务运行状况,发现并定位问题。

三、服务治理的三种形态演变

理解 Istio 的价值,最好从服务治理的演变史来看。从微服务诞生到现在,服务治理至少经历了三种形态。

形态一:治理逻辑写在应用代码里

在微服务早期,拆分服务后第一个问题就是:怎么找到对端服务?怎么选一个实例发请求?这些都靠自己写代码解决。

优点:简单,对外部依赖少
缺点:微服务越多,重复代码越多,维护越难;业务代码和治理逻辑耦合,不管是升级治理逻辑还是升级业务,都要改同一段代码

形态二:治理逻辑抽成公共库(SDK)

解决重复代码的思路很自然:把治理逻辑抽象成公共库,所有微服务引用它。典型的代表就是 Spring Cloud,它把服务发现、负载均衡、熔断等能力封装在框架中,只要用这个框架开发,就自带治理能力。

优点:代码层面解耦了业务和治理逻辑
缺点

  • 语言绑定:Spring Cloud 基于 Java,其他语言服务无法使用
  • 升级连带:治理逻辑升级时,即使业务代码没变,也要重新编译和部署整个服务

形态三:治理逻辑独立成进程(Sidecar)

这就是 Istio 采用的模式。治理逻辑完全从业务代码中剥离,以独立进程(Sidecar)的形式运行。业务代码和 Sidecar 各自独立运行、独立升级,互不干扰。

优点

  • 与开发语言无关,任何语言的服务都能接入
  • 升级独立,治理逻辑更新不影响业务
  • 对已有系统可渐进式改造,先接入 Sidecar,再逐步微服务化
形态治理逻辑位置语言绑定升级影响典型代表
形态一应用代码内无(但耦合严重)业务和治理都受影响自研框架
形态二SDK 公共库有(Java only)需重新编译部署Spring Cloud
形态三独立 Sidecar 进程独立升级,互不影响Istio

趋势总结:服务治理组件的位置在持续下沉,对应用的侵入越来越小。如果说微服务是一套理论和方法论,那么 Istio 就是一套完整的、可落地的实践工具。

四、Istio 与 Kubernetes 的关系

4.1 Kubernetes 擅长什么,不擅长什么

Kubernetes 在容器编排领域已经是事实标准,它提供了强大的应用部署、升级、扩容能力。Kubernetes 的 Service 机制也能做服务注册、发现和负载均衡。

但 Kubernetes 不擅长的是:服务间的熔断、限流、动态路由、调用链追踪等精细化的服务治理

4.2 Istio 与 Kubernetes 的互补关系

Istio 和 Kubernetes 的关系可以总结为八个字:Kubernetes 是基座,Istio 是帮手。

Istio 最大化地利用了 Kubernetes 的能力来构建自身功能:

数据面 Sidecar 运行在 Pod 里:Kubernetes 一个 Pod 可以运行多个容器的设计,让 Sidecar 可以"悄无声息"地注入到业务 Pod 中。用户创建负载的方式不变,Istio 自动注入 Proxy,对用户完全透明。

统一服务发现:Istio 直接基于 Kubernetes 的域名访问机制做服务发现,不需要再额外搭建 Eureka 这类注册中心,也避免了数据不一致的问题。

基于 Kubernetes CRD 描述规则:Istio 的所有路由规则和控制策略都通过 Kubernetes CRD(自定义资源)实现,数据存储在 Kube-apiserver 中,不需要另外的 API Server 和配置管理后端。Istio 的控制面组件本身也以 Kubernetes Deployment 和 Service 的形式运行在集群中。

一句话总结:Kubernetes 里已经有的,Istio 绝不自己再搞一套。Kubernetes 负责应用编排,Istio 负责服务治理,两者叠加形成端到端的容器应用运行治理平台。

五、为什么是 Istio

5.1 时代为什么选择 Service Mesh

在云原生时代,服务数量剧增、多语言并存、访问拓扑复杂,传统的 SDK 嵌入模式已经不够用。Service Mesh 将治理逻辑下沉为独立的基础设施层,如同 TCP/IP 协议栈一样——TCP/IP 负责把字节码可靠地在网络节点间传递,Sidecar 则负责把请求可靠地在服务间传递。这种模式天然契合云原生的弹性、动态特点。

当然,Sidecar 模式也带来了代价:每次请求多了两跳代理,增加了延迟和可能的故障点,也消耗了额外的系统资源。所以本质上是用额外的资源换取开发运维的灵活性、业务的非侵入性和扩展性

5.2 为什么 Service Mesh 选择 Istio

在众多 Service Mesh 实现中,Istio 之所以脱颖而出,有几个关键原因:

  • 控制面设计先进:Istio 早期使用 Envoy 作为数据面代理,并定义了标准的控制面 API(xDS 协议),解耦了控制面和数据面,使得架构更加灵活
  • 大厂推动:由 Google、IBM 联合推出,华为、思科、红帽等主流厂商持续投入,社区活跃度和生态成熟度远超其他同类项目
  • 云厂商内置:华为云 CCE、Google GKE 等主流云平台已内置 Istio,提供开箱即用的服务治理能力
  • 与 Kubernetes 深度绑定:不是简单地把 Kubernetes 当作运行环境,而是充分复用 K8s 的 CRD、服务发现、RBAC 等能力,实现了"K8s 有的我不重复造轮子"的设计哲学

总结:云原生应用采用 Kubernetes 构建应用编排能力,采用 Istio 构建服务治理能力,正逐渐成为企业技术转型的标准配置。两者形成闭环——Kubernetes 管好容器,Istio 管好通信。